Mostrando postagens com marcador desenvolvimento. Mostrar todas as postagens

segunda-feira, novembro 21, 2011

Mapa da Cobertura 3G no Brasil

Enquanto no mundo todo o 4G já é uma realidade, no Brasil ainda estamos engatinhando no 3G. O mais frustrante é que não é segredo pra ninguém que as operadoras de telefonia móvel entregam menos velocidade que o contratado nos planos de dados, mas e quanto a cobertura do sinal? Dá para confiar nas teles? 

Em uma iniciativa louvável, o desenvolvedor Gabriel Subtil criou o site colaborativo www.sinal3g.com.br onde os usuários podem indicar as localidades em que o sinal está disponível, falho ou ausente. O site usa a API do Google Maps em conjunto com a enorme quantidades de usuários de modens e smartphones 3G ávidos por compartilhar suas experiências de acesso.

Então antes de contratar um plano de dados 3G, que tal dar uma passadinha no mapa e verificar se na sua área tem cobertura? Pelo menos essa me parece uma opção mais confiável que os sites e os atendentes de telemarketing das operadoras de telefonia! 

Ahhh! E se descobrir alguma falha na cobertura, como área que deveria estar coberta, ou área com sinal, mas não indicada, dá uma colaborada lá! Os consumidores agradecem!

Mapa Colaborativo do Sinal 3G no Brasil

Visualizar Sinal 3G em um mapa maior

quarta-feira, junho 29, 2011

Android & Eclipse: Dando “Alô” de diversas formas – Parte 2

No nosso último encontro, estudamos um pouco sobre o sistema de construção de layouts independentes que a Android SDK oferece  e a qual nos permite criar facilmente diversas formas de visualização para um mesmo conjunto de dados. Tivemos, inclusive, a oportunidade de construir nosso primeiro layout pessoal, utilizando o modelo mais simples e de fácil utilização pelo usuário, o Layout Linear.

Hoje, continuaremos analisando outras opções de layout pré-definidas por nossa biblioteca...

Layout Relativo

O modelo de distribuição de elementos na tela do layout relativo, concentra-se principalmente em posicionar um elemento ou grupo de elementos de acordo com a posição relativa do mesmo ao seu predecessor (abaixo, à direita, à esquerda), de tal forma que elimina a necessidade de termos diversos grupos de elementos de visão (viewgroups) aninhados.

Não entendeu? Bom, deixe-nos explicar de outra maneira: Lembra em nosso último post quando para termos o resultado esperado (a tela preenchida com uma linha com diversas colunas coloridas e outra com uma mensagem particionada) tivemos que aninhar diversos elementos de tipo LinearLayout com diferentes orientações? Esse problema não existe no layout relativo, onde o mesmo resultado pode ser obtido utilizando tão somente um único elemento RelativeLayout. Inclusive, a documentação mesmo aconselha ao usuário que se determinado layout linear estiver resultando em um número excessivo de aninhamentos, o mesmo deveria ser abandonado em favor do uso de outros modelos de layout, em especial, o layout relativo.

Então, vejamos como acontece a criação de um layout relativo com um pequeno exemplo:


    android:layout_width="fill_parent"
    android:layout_height="fill_parent">
   
        android:id="@+id/label"
        android:layout_width="fill_parent"
        android:layout_height="wrap_content"
        android:text="Digite aqui:"/>
   
        android:id="@+id/entry"
        android:layout_width="fill_parent"
        android:layout_height="wrap_content"
        android:background="@android:drawable/editbox_background"
        android:layout_below="@id/label"/>


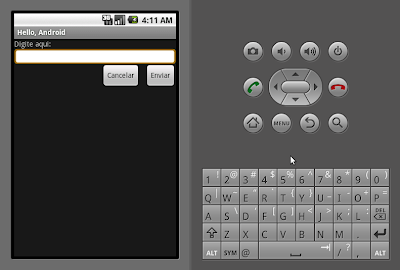
Entendendo o código: Comparando o código acima com o gerado em nosso modelo linear, é possível ver a diferença na quantidade de atributos que cada componente apresenta. A maioria do tipo android:layout_*. Além de nossos conhecidos width e height, agora o modelo exibe uma série de outros elementos novos como below, toLeftOf, alignParentRight e alignTop, que vamos descrever abaixo:

android:layout_below, android:layout_toLeftOf e android:layout_toRightOf: Definem a posição do elemento quando comparado ao elemento cujo id é igual ao valor da propriedade. Ex: o último elemento button de texto igual a “cancelar”, deve estar localizado a esquerda (toLeftOf) do elemento de id igual a “@id/ok”.

android:layout_alignParentRight, android:layout_alignParentLeft, android:layout_alignTop: Definem o alinhamento do elemento quando comparado a um outro elemento presente no mesmo grupo de visão (no caso de alignTop, por exemplo) ou ao próprio viewgroup(alignParentRight e alignParentLeft. Ex: o último elemento button de texto igual a “cancelar” está com seu topo alinhado com o do elemento “@id/ok” enquanto está alinhado diretamente a direita do próprio elemento RelativeLayout.

Por fim, percebeu que expandimos a quantidade de elementos construtores em nosso último exemplo? Além de nosso velho conhecido elemento TextView que trabalhamos em nosso primeiro projeto, neste novo post somos apresentados ao EditText para edição de mensagens e dois elementos do tipo Button, que executam determinada rotina de trabalho quando são pressionados pelo usuários. Embora, nesse exemplo sua função é meramente ilustrativa..

Agora, abra o arquivo hello.java e edite as linhas a seguir:

public void onCreate(Bundle savedInstanceState) {
        super.onCreate(savedInstanceState);
        //setContentView(R.layout.main);
        setContentView(R.layout.relative); }

Execute a aplicação e se tudo correr bem, sua aplicação terá essa aparência:


Bacana, não é? Já consegue ver aquela tão sonhada interface gráfica para seu software se desenhando através de nossas dicas? Então, mãos a obra e treinemos um pouco! Como dica, tente alterar a configuração dos atributos em relative.xml e ver como cada elemento se comporta.

Outra experiência interessante seria tentar refazer o mesmo resultado que obtivemos com o layout linear, através dos novos atributos proporcionados pelo layout relativo e de forma tal que não tenhamos que recorrer a aninhamentos de visões.

Até a próxima!


segunda-feira, junho 27, 2011

Cloud Computing: Aprendendo a Programar nas Nuvens - Introdução


Este post inicia uma nova série sobre cloud computing cujo intuito é dar noções iniciais sobre essa badalada tecnologia. Para que não sabe ou lembra, já escrevemos alguns posts introdutórios sobre o tema e cuja leitura é recomendada: Cloud Computing - Programando nas Nuvens, Aprenda Cloud Computing com a Microsoft e Quer começar a programar em nuvem? Veja aqui as opções.

Apesar de causar arrepios em alguns, com uma possível perda de privacidade, a ideia de cloud computing já está consolidada na Internet onde aparece desde redes sociais, passando por discos virtuais até reservatório de músicas.

Nesse pequeno post introdutório, vamos explicar resumidamente o que é o Google App Engine e seus principais pontos.

O Google App Engine é toda a infraestrutura de programação em nuvens provida pelo Google. Isso significa que sua aplicação ficará hospedada nos servidores do Google e estará disponível para acesso de qualquer lugar onde haja Internet. 

O App Engine é gratuito mas com algumas limitações: 10 aplicativos por conta de desenvolvedor; cada aplicativo pode utilizar 500 MB de armazenamento e 5 milhões de visualizações de páginas por mês. Para  mais recursos pode-se pagar, o que pode desanimar alguns, mas é fácil perceber que quando estiver próximo ao limite da cota, sua aplicação provavelmente já terá bastante receita para pagar por infraestrutura.

Várias linguagens de programação são suportadas, como Javascript e Ruby, mas o ambiente é fortemente orientado para Java e Python. O que acaba atendendo praticamente a todo o público de desenvolvedores, já que praticamente todo mundo aprende Java na faculdade.

As aplicações rodam em uma sandbox que permite um ambiente seguro para desenvolvimento e produção. O acesso ao sistema operacional das máquinas hospedeiras é limitadíssimo. Não é possível ler arquivos, exceto os fornecidos com o código fonte da aplicação. Toda a entrada e saída de dados é feita através de URLS e emails.

Outro ponto que merece destaque é o armazenamento de dados. Trata-se de uma forma não convencional de armazenamento, ou seja, nada do banco de dados relacional padrão. Ao invés disso definimos entidades com propriedades que são armazenadas remotamente. Este tópico será melhor abordado em um futuro post.

Um recurso bastante interessante é a possibilidade de utilizar contas do Google para fazer login na sua aplicação, assim não será necessário criar todo um sistema de controle de usuários e acesso.


O Google App Engine é um ótimo começo para quem pretende aprender a programar nas nuvens, pois não exige uma curva de aprendizado muito acentuada, bem como novas linguagens e paradigmas. No próximo post você aprenderá a preparar sua máquina para desenvolver aplicações na nuvem.

domingo, junho 26, 2011

Apple libera o iOS beta 2 para Desenvolvedores

Na última sexta-feira(24/06/2011), a Apple presenteou os milhares de desenvolvedores e entusiastas de seus produtos disponibilizando o SDK da nova versão beta do iOS, o sistema operacional utilizado pela empresa nos produtos portáteis iPad, iPhone e iPod Touch.

Entre as novidades da versão 5.0 do sistema operacional já descobertas pelos programadores, estão uma maior interação com o serviço de Cloud Computing (Programação nas Nuvems) iCloud e atualização de sistema através de conecções Wi-Fi e redes 3G. Mais um passo da empresa de Steve Jobbs para deixar seus produtos cada vez mais independentes da conexãos com computadores.

Além do iOS, a Apple também liberou versões beta 2 do software multimídia iTunes 10.5 e do Apple TV Software, o aparelho que permite transformar sua TV em uma central multimídia com total sincronia com os demais produtos da empresa e acesso a uma loja de programas (a exemplo da appStore e da iBooks Store) onde é possível adquirir a mídia e exibi-la diretamente em Alta Defenição na sua TV.

Ficou interessado? Então você já pode acessar o iOS Dev Center e conferir as novidades, logicamente desde que você tenha uma licensa de desenvolvedor.

Mas, se deseja saber mais ainda sobre as inovações do iOS beta 2, o site MacMagazine está fazendo uma cobertura das inovações assim que são descobertas pelos developers de todo mundo ou noticiadas pela própria Apple.


quarta-feira, maio 25, 2011

Programando para Android: Criando uma aplicação com o Eclipse IDE - Parte 2

Antes de começarmos, é importante que seu ambiente de desenvolvimento já esteja preparado e configurado para criar aplicações para Android, por isso sugiro ler o post anterior.

Programar para Android é muito fácil, afinal: Java é ensinado em 99% das escolas de informática ao redor do mundo! Para ilustrar isso vamos fazer o mundialmente famoso "Hello World" e para você criar também, só basta seguir o passo a passo abaixo.

Abra o Eclipse e clique no menu "File", depois no submenu "New" e por fim em "Project...". Uma janela semelhante a mostrada abaixo se abrirá:


Clique em "Android", depois em "Android Project" e por fim em "Next > ". Uma janela de propriedades se abrirá, aqui devemos determinar as configurações básicas iniciais do nosso projeto.


Coloque o nome do projeto de "Hello Droid". Em "Build Target" devemos selecionar qual versão do Android nossa aplicação será testada, clique em Android 1.5. Note que a cada versão do Android, temos um nível de API diferente.

Em "Aplication Name" coloque "Hello Droid", este será o nome da nossa aplicação quando instalada em um dispositivo.

Em "Package name" coloque "com.cafecombits.hellodroid". Neste campo devemos seguir uma hierarquia, começamos com "com", de "company", seguido da companhia em si, "cafecombits", depois podemos hierarquizar da forma que nos convier, sempre colocando o nome da nossa app por último, por exemplo: "com.cafecombits.games.crazychess", "com.cafecombits.tools.coffeemachine".

Marque a opção "Create Activity" e escreva: "hello". Activitys são equivalentes a janelas no mundo da programação Desktop.

Em "Min SDK Version" coloque "3", esta é a versão mínima do Android necessária para rodar sua aplicação. Em caso de dúvidas olhe na tabela "Build Target" em API Level. Por exemplo, se a versão mínima é a 2.2, coloque 8.

Agora é só clicar em finish e seu projeto se abrirá conforme mostrado abaixo:


A estrutura de pastas do nosso projeto está sendo mostrada a esquerda. A pasta "src" contém o código em java de nossa aplicação. A pasta"res" contém 3 subpastas, "drawable", onde colocamos as imagens, "layout", onde ficam os arquivos XML que guardam a forma visual de nossas activitys, e a pastas "values", onde existe um arquivo especial chamado "strings.xml", onde podemos colocar todas as strings que nossa app irá utilizar. Como podemos ver o Android foi pensado na torre de babel das línguas do mundo. E com a centralização de strings em arquivos fica fácil fazer a tradução da nossa aplicação para outros idiomas.

Na direita, podemos ver que está aberto o arquivo hello.java, que contém o código da nossa activity inicial. Basicamente ele cria a activity e seta seu arquivo de layout. Sim! Aquele da pasta "res/layout" chamado "main.xml".

Se você abrir o arquivo "main.xml", vai ver uma imagem semelhante a essa, onde podemos ver uma paleta de contoles a esquerda e opções de visualização em cima:


Então você me diz, mas espere um pouco, isso não é um arquivo XML? A resposta é sim! O Eclipe abre um editor que facilita a visualização e edição do layout de nossa activity, mas se você preferir, pode ver o código XML puro clicando embaixo na aba "main.xml" ao lado de Graphical Layout".

Como podemos ver o projeto padrão já criou uma frase emblemática em nossa app. Como podemos alterar essa frase? O código XML de nossa acitivity não explica muita coisa, podemos notar que o nosso arquivo não armazena o conteúdo da string da frase diretamente, mas carrega seu conteúdo a partir de uma string definida no arquivo "strings.xml", contido na pasta "res/values". Ao abrir esse arquivo, devemos clicar na string "hello", então na direta poderemos editar em "value":


Digite "Hello Droid!" e pronto, nossa aplicação já pode ser compilada e testada! Clique na aba "hello.java", depois em "Debug" ou aperte "F11" e a tela do emulador com nossa aplicação se abrirá.

Caso você ainda não tenha nenhum emulador definido, pode criar um clicando no menu "Window -> Android SDK and AVD Manager".

Veja o resultado final de nossa app:


Divirtam-se!

quinta-feira, março 10, 2011

Android está dando mais dinheiro


Os desenvolvedores de aplicativos para o sistema do robozinho estão lucrando mais que em outras plataformas.

O jornal inglês "The Telegraph" publicou uma matéria onde afirma que o "caótico" Android Market está muito mais movimentado, e lucrativo, que a "certinha" Apple Store.

A "Spacetime Studios", desenvolvedora do game "Pocket Legends", afirma que o número de downloads diários para Android é de 9000 e para iOS de 4000, além das vendas no Android serem de 30 a 50% maiores.

Apesar de um certo descaso do Google com o Market, as boas notícias para que desenvolve para Android não param de surgir!


quarta-feira, agosto 18, 2010

Programando para Android : Conhecendo o Google Android


Motivado pelo ingresso do colega Solleon no mundo dos smartphones de baixo custo como o GPad, Acabei me interessando pelo lado do desenvolvedor desse tipo de dispositivo. Afinal, com tantas possibilidades para entrar nesse mundo, qual seria o melhor OS ou pelo menos aquele com maior potencial de crescimento? Java for Mobile Devices, Windows mobile, Symbiam, Iphone, Blackberry.. quem escolher?

Em pesquisa realizada pelo Gartner, até o final do segundo trimestre desse ano as vendas de aparelhos celulares alcançaram os números de 325,6 milhões, representando um crescimento de 13,8% em comparação com 2009. Um ponto interessante nesses números é que 19% desses aparelhos são smartphones, ou seja, aqueles celulares avançados com diversas funcionalidades disponíveis como acesso a e-mails, IM, internet (alguns até com acesso a redes wi-fi), GPS, Bluetooth, além de outros aplicativos como suítes de aplicativos para escritório, etc..

E nesse campo eu aposto as minhas fichas no "robôzinho" da Google. E não é para menos, segundo a mesma pesquisa o crescimento de vendas dos celulares com Android subiu de mínimos 756 mil aparelhos vendidos em 2009 (1,8% de participação no mercado) para 10 milhões no segundo trimestre de 2010 (17,2% de participação no mercado), quando alcançou o terceiro lugar entre as plataformas móveis mais utilizadas. Atrás apenas do Symbian da Nokia e da RIM (fabricante do Blackberry) e à frente da Apple (quem diria não é?). E esse bom desempenho não se deve apenas pelo peso do nome da Google...


Para entendermos o sucesso do Android, temos que entender primeiramente o contexto no qual ele fora criado. Antes de mais nada, no mercado de telefonia móvel, o foco da competição entre as empresas se dá pela venda de aparelhos e não pelos OS e aplicativos em si, logo nada mais natural que empresas como a Google, HTC, LG, Motorola, Samsung, Sony Ericsson, Toshiba, Sprint Nextel, China Mobile, T-Mobile, Asus, Intel, Garmin, entre outras se unirem em uma aliança para o desenvolvimento de uma plataforma de desenvolvimento de código aberto, única e flexível. Essa aliança ficou conhecida como OHA ou Open Handset Alliance, e foi o estopim para o surgimento do robôzinho.

Logo, para servir aos designos da OHA, o Android foi criado baseado no sistema Linux e visando oferecer uma plataforma única e instalado em qualquer dispositivo fornecido por alguma das empresas componentes da OHA. Além disso o sistema foi construído com recursos de integração e flexibilidade permitindo que aplicativos fornecidos nativamente pelo sistema possam ser substituídos por versões customizadas que podem interagir ou não com outras aplicações nativas, o que pode ser útil para as fabricantes criarem serviços ou alguma forma de marketing diretamente na interface do OS.

E do lado dos desenvolvedores, o campo também é bastante promissor. Além do grande número de sites e blogs que oferecem conteúdo voltado para a criação de aplicativos para o OS (dentre eles o site oficial voltado para desenvolvedores), existem algumas vantagens no desenvolvimento para plataforma:

  • A Google financia concursos de desenvolvimento para a plataforma. O maior desses concursos, o Android Developer Challenger, teve um investimento de U$ 10 milhões em prêmios e com a distribuição de U$ 275.000,00 para as 20 melhores aplicações. Além do benefício direto para os participantes em forma de premiação, a comunidade ganha com a grande quantidade de aplicativos disponíveis para uso que surge durante o processo de avaliação desses concursos.
  • Android Market, loja virtual para desenvolvedores. A exemplo da AppStore da Apple, o Android conta com uma loja virtual para os desenvolvedores disponibilizarem gratuitamente suas aplicações ou lucrar com a sua venda.
  • Fácil integração com os serviços Google. Lógica? Nem tanto... Apesar de boa parte dos smartphone hoje em dia utilizarem de vários serviços google como o Gmail ou o Google Maps, em geral eles usam uma versão em Java bem limitada. O Android permite utilizar todo o potencial das Google Apps, ainda mais quando integrado a um bom plano 3G.
  • SDK aberta e disponível gratuitamente. Através do site que associei acima, é possível fazer o dowload facilmente da SDK e começar a programar usando a IDE de sua escolha. Apesar do site já reservar alguns plugins a ferramentas que favorecem os usuários da Eclipse IDE. Além dessa IDE, recentemente a Google lançou uma suite de desenvolvimento voltada para não programadores onde o objetivo é que as aplicações possam ser construídas sem a necessidade de se digitar uma linha de código sequer.

Gostou?

Nos próximos posts exploraremos um pouco mais a respeito do meios para o desenvolvimento de aplicativos para o robôzinho da Google.


sexta-feira, julho 10, 2009

SQLite e Relacionamentos

Para quem não conhece, o SQLite é um banco de dados leve open source, escrito em C, transacional que não precisa de servidor e sem necessidade de configuração. O banco destaca-se pela sua ótima performance e portabilidade. E como usamos esse banco então? Basta nós adicionarmos a lib (dll) do SQLite em nossos projetos. Para saber mais acesse a home page do projeto http://www.sqlite.org/.

Uma das suas grandes deficiências é a falta de relacionamentos. Porém como o banco suporta triggers, muita gente implementa esses relacionamentos através destas. Assim ao invés de você criar um relacionamento, você cria várias triggers. Para ilustrar o que estou falando vamos a um exemplo da criação de um relacionameto em um banco de dados relacional qualquer:

CREATE TABLE casa (
id INTEGER NOT NULL PRIMARY KEY
);

CREATE TABLE morador (
id INTEGER NOT NULL PRIMARY KEY,
casaId INTEGER
CONSTRAINT fk_casa_id REFERENCES casa(id)
);
No SQLite, este relacionamento é implementado da seguinte forma:

-- Foreign Key Preventing insert
CREATE TRIGGER fki_morador_casaId_casa_id
BEFORE INSERT ON [morador]
FOR EACH ROW BEGIN
SELECT RAISE(ROLLBACK, 'insert on table "morador" violates foreign key constraint "fki_morador_casaId_casa_id"')
WHERE NEW.casaId IS NOT NULL AND (SELECT id FROM casa WHERE id = NEW.casaId) IS NULL;
END;

-- Foreign key preventing update
CREATE TRIGGER fku_morador_casaId_casa_id
BEFORE UPDATE ON [morador]
FOR EACH ROW BEGIN
SELECT RAISE(ROLLBACK, 'update on table "morador" violates foreign key constraint "fku_morador_casaId_casa_id"')
WHERE NEW.casaId IS NOT NULL AND (SELECT id FROM casa WHERE id = NEW.casaId) IS NULL;
END;

-- Foreign key preventing delete
CREATE TRIGGER fkd_morador_casaId_casa_id
BEFORE DELETE ON casa
FOR EACH ROW BEGIN
SELECT RAISE(ROLLBACK, 'delete on table "casa" violates foreign key constraint "fkd_morador_casaId_casa_id"')
WHERE (SELECT casaId FROM morador WHERE casaId = OLD.id) IS NOT NULL;
END;
Como pode-se ver, não é nenhum pouco prático, no entanto seguindo essa onda de WEB 2.0 foi criado um serviço na internet que já cria esses códigos automaticamente para você, bastando que nós colemos o código de criação do relacionamento. Para usar esse serviço acesse http://rcs-comp.com/site/index.php/view/Utilities-SQLite_foreign_key_trigger_generator e aproveite para melhorar seu banco!.

segunda-feira, julho 06, 2009

Instalando o Ruby on Rails

Em se tratando de desenvovimento WEB, ágil, moderno e eficiente, nada mais natural que se falar em Ruby on Rails. Nesse post nós aprenderemos como instalar essa grande ferramenta.

Instalando no Windows

Instalar este framework no sistema operacional do tio Bill é mamão com açucar. Isso porque uma alma caridosa, Curt Hibbs, juntou tudo em um único arquivo e disponibilizou na web, assim como o EasyPHP. Esse pacote se chama InstantRails e contém Ruby, Rails, SQLite, MySQL, Apache, etc. Vamos aos passos para instalá-lo:

  1. Baixe o InstantRails da seção de downloads site http://instantrails.rubyforge.org/wiki/wiki.pl.
  2. Descompacte o conteúdo em um diretório, de preferência na raiz de alguma partição. Ex: "C:\InstantRails" ou "D:\InstantRails"
  3. Acesse o diretório escolhido e execute o InstantRails. Se aparecer uma janela perguntando se você quer gerar novamente os arquivos de configuração, clique em sim.
Na janela do InstantRails você pode monitorar o status do Apache,do MySql e de suas aplicações Rails. Lembre-se que para digitar os comandos do Rails, você SEMPRE deve abrir o console para digitar os comandos. Para isso, clique no botão com o ícone do InstantRails do lado do botão Apache, menu Rails Applications, Open Ruby Console Window, como na imagem a seguir:

Ruby on Rails instalando, é hora de atualizar a sua versão para a mais nova, devemos abrir o console, conforme explicado no parágrafo anterior e digitarmos no prompt:

C\:InstantRails> gem update rails --include-dependecies

Instalando no Linux

No Linux a instalação é menos prática, mas em compensação o framework ao final já estará atualizado e totalmente integrado ao sistema.

Independente da distribuição Linux usada, teremos que instalar o interpretador Ruby, depois o gems, que a partir daí instalará o Rails. Nós usamos o Ubuntu 9.04 Jaunty Jackalope para demonstração. Para instalar, abra o prompt e digite:
$sudo aptitude update
$sudo aptitude install build-essential
$sudo aptitude install ruby rubygems ruby1.8-dev libsqlite3-dev
$sudo gem install -y rails
$sudo gem update sqlite3-ruby

Pronto seu Ruby on Rails está instalado! =D

quinta-feira, maio 21, 2009

Liberado Visual Studio 2010 Beta


Nessa segunda dia 19, foi liberado para download o Beta da nova versão da IDE de desenvolvimento de sistemas da Microsoft, o Visual Studio 2010.

Entre as novidades da nova versão estão:


  • Aprimoramento da interface gráfica: com uma organização mais clara, redução de complexidade, janelas e documentos flutuantes, editor melhorado.
  • Programação paralela: Agora disponível tanto para usuários de código nativo e gerenciado e com suporte embutido na própria IDE.
  • Gerenciamento do ciclo de vida de aplicações: Prometendo ferramentas para todos os envolvidos no projeto de software, desde arquitetos a programadores e testadores. Incluindo construção de novos tipos de diagramas com use cases e diagramas de sequência e atividade, um novo motor de testes e uma nova ferramenta de controle de workflow.

  • Desenvolvimento WEB: Novo motor de intellisense de Javascript,suporte a SilverLight,  "One click deployment" que permite publicar todo o site e suas dependências de uma só vez.
  • Cloud Computing: Windows Azure Tools já integradas por padrão na IDE.
  • Suporte nativo a mais Databases: Agora é possível utilizar as classes de acesso a dados nativos do .NET Framework para BDs baseados em IBM DB2 e Oracle.


Ficou interessado? Pode conferir o novo VS 2010 aqui.

Aprenda Cloud Computing com a Microsoft


Para quem quer aprender a programar para a nuvem sem muito esforço, a Microsoft disponibiliza uma área específica no portal MSDN (voltado para desenvolvedores de produtos microsoft) para o estudo das características e funcionalidades do Windows Azure, a plataforma para Cloud Computing da empresa, o desenvolvimento e deployment de aplicações para a nuvem e a integração com outros serviços, como o SQL Services e ferramentas de colaboração da série Live.

Chamada Azure Academy, essa área disponibiliza apresentações em forma de vídeos e transparências que guiam o estudante desde os conceitos introdutórios da estrutura e objetivos envolvidos no desenvolvimento da plataforma Azure até a distribuição de serviços e  aplicações na nuvem. O forte das apresentações é, sem dúvida, a linguagem de fácil entendimento e a presença de demontrações explicativas que facilitam o entendimento do conteúdo apresentado.

Para o desenvolvimento para Windows Azure, é utilizado o Visual Studio 2008 integrado com com o Windows Azure SDK e o conjunto de ferramentas para do Windows Azure para o Visual Studio.


domingo, maio 17, 2009

C# 4.0 - Acesso a tipos dinâmicos

Anteriomente falamos sobre o lançamento do C# 4.0, linguagem de programação para o .NET Framework da Microsoft que virá juntamente com o novo IDE da empresa para o desenvolvimento de aplicações para desktop e web.

Hoje, explicaremos um pouco mais sobre as modificações inerentes ao C#, especialmente em sua relação com produtos de outras linguagens.

Bom, estamos acostumados a utilizar atualmente classes tipadas estáticamente do próprio .NET framework e invocando seus próprios métodos. Por exemplo, tomemos o exemplo de uma classe que implemente uma Calculadora, segundo essa abordagem o código necessário para se executar uma operação de soma seria mais ou menos o seguinte:

Calculator calc = GetCalculator();
int sum = calc.Add(10, 20);


Já quando decidimos usar uma classe não tipada estaticamente, como as contruídas em COM, Ruby, Python ou até Javascript. Por não possuir um sistema de tipos reconhecido naturalmente pelo .NET Framework, devemos usar Reflection para descobrir os atributos de tipo em tempo de execução e dinamicamente invocar o método desejado como o mostrado abaixo:

object calc = GetCalculator();
Type type = calc.GetType();
object result = type.InvokeMember("Add",
BindingFlags.InvokeMethod, null,
new object[] { 10, 20 });
int sum = Convert.ToInt32(result);


Com o advento do .NET Framework 3.5, o tratamento do mesmo tipo de problema vindo de classes Javascript, poderia ser resolvido da seguinte forma:

ScriptObect calc = GetCalculator();
object result = calc.InvokeMember("Add", 10, 20);
int sum = Convert.ToInt32(result);


Agora, com o C# 4.0 o uso de classes dinâmicas tomará a seguinte forma:

dynamic calc = GetCalculator();
int result = calc.Add(10, 20);


Essa simplificação no uso de tipos dinâmicos torna-se possivel pela adição do novo tipo estático Dynamic que converte um objeto dinâmico em estático. Parece algum tipo de incoerência mas essa abordagem tem suas vantagens, principalmente por possibilitar uma maior interação entre os objetos estaticamente nativos do .NET e classes oriundas de diversas origens, bem como estimula o uso da codificação estática e seus benefícios pelo maior período de tempo possível.

Por hoje é só, logo voltaremos com novas informações a respeito das mudanças na linguagem C# e no próprio .NET Framework.

sexta-feira, maio 15, 2009

Validando Expressões Facilmente em ASP.NET

Se você é programador ASP.NET e costuma utilizar os componentes da aba validation da Toolbox do  MS Visual Studio, provavelmente já se deparou com o trabalho árduo de criar expressões de validação para campos de texto específicos como Data,Endereços, Telefones, CEP, CPF, CNPJ, etc.. Infelizmente, a IDE da microsoft possui poucas referências prontas e o trabalho de criação de novas expressões é, no mínimo, broxante.

A solução pode vir com o site RegExLib.com. Trata-se de uma biblioteca formada por Validations Expressions criadas por milhares de desenvolvedores em todo o mundo. Todas elas possuem o código disponível livremente, seguido por uma descrição a respeito da aplicação da expressão e exemplos de dados aceitos ou não pela expressão. Inclusive, caso você seja criativo ou tenha uma expressão de validação que deseja compartilhar, o sistema oferece a oportunidade de submeter o código para a rede em instantes. Vale a pena dar uma conferida.

terça-feira, maio 12, 2009

Vem aí o novo C# 4.0

Em 1998, ao mesmo tempo em que a Microsoft em um período que coincidiu com o surgimento do .NET Framework da Microsoft, nascia a linguagem C#. Criada a partir das características encontradas em linguagens de alto nível como C++ e Java e com o objetivo de ser uma linguagem de programação simples, moderna e totalmente orientada a objetos (inclusive utilizando o conceito de type-safe para garantir essa qualidade) a linguagem de programação foi lançada oficialmente no verão do ano 2000, tornando-se a partir de então uma das linguagens mais utilizadas na atualidade. Tanto que a demanda  por sua utilização em atividades diversas resultou na própria evolução da linguagem.

A versão 2.0, por exemplo, trouxe como mudanças como o suporte a generics, métodos anônimos, iterators, tipos parciais e tipos nulos. E não parou por aí, mais tarde com os esforços de se incluir o suporte ao LINQ, o componente do .NET Framework que permitiria incorporar as capacidades de consultas às linguagens .NET, o C# evoluiu mais uma vez.

Na versão 3.0, foram incluídas as seguintes funcionalidades: variáveis locais tipadas implicitamente, vetores tipados implicitamente, inicializadores de collections, tipos anônimos, métodos extensivos, Lambda Expressions, Query Expressions e Expressions trees.

Agora, com o advento do .NET Framework 4.0 e o MS Visual Studio 2010, o C# está prestes a mudar novamente. Dessa vez a fonte de inspiração para a mutação da linguagem vem das tão populares linguagens de programação dinâmicas como Perl, Python e o Ruby, utilizando os métodos de desenvolvimento ágil e propiciar um ambiente sem a necessidade de escrever grandes blocos de códigos, de tal forma a não prejudicar a eficiência e incrementar a produtividade.

Entre as características divulgadas pelo C# 4.0 estão:

Nos próximos posts comentaremos um pouco sobre as inovações relativas a linguagem em si e como o C# pretende tornar a experiência da implementação de códigos no sistema menos dolorosa.

terça-feira, abril 28, 2009

Migrando o desenvolvimento de aplicações para o mundo do software livre – Parte II

Mudando de paradigmas

Analisando a evolução do desenvolvimento de aplicativos dos sistemas operacionais Windows e Linux conforme visto na parte I desse artigo, pudemos perceber claramente como a forma de se pensar na programação (principalmente na etapa de implementação) do produto final varia de acordo com o S.O que utilizaremos como padrão para o nosso sistema. Por um lado temos o Windows e seus programas enormes e “auto-sustentáveis”, mas com IDEs que incrementam a produtividade dos programadores através de ferramentas que prezam pela facilidade de uso e grande quantidade de recursos e são financiadas por grandes empresas de software, enquanto do lado oposto temos o Linux, suas aplicações rápidas e leves, desenvolvimento consciente e independência de fornecedores e recursos necessários para sua execução supridas pelo sistema.

Tomando por experiência própria, uma das maiores vantagens encontradas em IDEs do sistema Windows é, sem dúvida, a usabilidade e quantidade de recursos disponíveis. Interfaces intuitivas e fáceis de configurar e uma infinidade de componentes que necessitam de pouca coisa além de arrastar, soltar e modificar alguns parâmetros para funcionar. Além disso, programas como o Delphi e o Visual Studio fornecem a possibilidade de se construir uma aplicação desde a etapa de modelagem até a distribuição, sem recorrer a outros recursos.

No Linux, por muito tempo predominava-se a adoção de uma diversidade muito maior de linguagens de programação, interpretadores e compiladores, estes muitas vezes embutidos dentro das próprias distribuições do S.O e poupando o usuário do tempo necessário para a busca do mesmo. Bastava (ou basta, considerando que esse cenário ainda é válido) o usuário iniciar qualquer editor de texto e descrever o código do programa na linguagem escolhida (C/C++, Perl, Java, PHP, Python, entre outros) e executar o interpretador/compilador através do Shell.

Entretanto, esse quadro mudou com o advento de ferramentas como o Kylix, um produto da Borland voltada para os usuários de Linux que também trabalhava com a linguagem Object Pascal como seu irmão para o Windows; Anjuta e o CMake, para desenvolvimento em C/C++; o KDevelop, ótima IDE gráfica baseada nas bibliotecas do KDE e Qt e que possibilita o desenvolvimento para uma infinidade de linguagens que variam do C/C++ (padrão do software) ao Java, passando pelo PHP e Python. Mais informações, podem ser encontradas no website do projeto.


Sem falar das famosas IDEs para o desenvolvimento Java como o NET Beans, distribuído e mantido pela própria Sun e o Eclipse, desenvolvido a princípio pela IBM e que mais tarde tornou-se open source onde apesar de ganhar notoriedade pelas ferramentas e recursos para desenvolvimento em Java, pode ser usada para o desenvolvimento em outras linguagem, desde que extensões compatíveis sejam instaladas. Ambas possuem, entretanto, a característica de serem modulares e adequarem-se as necessidades do usuário.


Se você ficou interessado em iniciar a programar em Linux, não perca o próximo post da série com uma lista de ferramentas disponíveis para o S.O tanto nas etapas de implementação de código, quanto em modelagem de sistemas e distribuição e seus similares no ambiente Windows.


sábado, outubro 11, 2008

Live Search usando AJAX, PHP e MYSQL

Um recurso muito legal e útil usado em páginas da web 2.0, é o chamado “live search”. O live search consiste em uma caixa de pesquisa cujos resultados são exibidos em tempo real sem precisar recarregar toda a página. O exemplo é bem simples e pode ser visto em http://solleon.hostdegraca.com/cafecombits/livesearch/, onde basta digitarmos três letras e o resultado da pesquisa já é exibido logo a baixo.

Vamos agora demonstrar passo a passo como fazer uma busca do tipo “live search” para suas aplicações online.

Passo I – Fazendo um banco de dados para o exemplo

Para o exemplo vamos criar um banco de dados em MYSQL bem simples, contendo somente uma tabela, como monstrado a seguir:
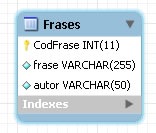
bd

O script de criação do BD é:


SET SQL_MODE="NO_AUTO_VALUE_ON_ZERO";

--
-- Banco de Dados: `exemplo`
--

-- --------------------------------------------------------

--
-- Estrutura da tabela `Frases`
--

CREATE TABLE IF NOT EXISTS `Frases` (
`CodFrase` int(11) NOT NULL auto_increment,
`frase` varchar(255) NOT NULL,
`autor` varchar(50) NOT NULL default 'Desconhecido',
PRIMARY KEY (`CodFrase`),
KEY `frase` (`frase`,`autor`),
FULLTEXT KEY `frase_2` (`frase`)
) ENGINE=MyISAM DEFAULT CHARSET=latin1 COMMENT='Frases interessantes' AUTO_INCREMENT=49 ;


Se preferir baixar este script, clique aqui.


Para excecutar o script de criação, podemos abrir o prompt de comando e simplesmente digitar:


shell> mysql < arquivo_texto


Também podemos abrir o client mysql e digirtar:


mysql> source filename


O client fará tudo de forma automatizada e teremos nosso banco de dados criado.


Cadastre algumas frases no banco de dados para poder vizualisar o exemplo mais tarde.


Passo II – Criação da página HTML para pesquisa e exibição dos dados


Nossa página em HTML será bem simples, terá apenas uma caixa de busca no topo, onde o usuário irá digitar uma palavra, e as frases que a contiverem serão exibidas logo abaixo.


Seu código HTML deve conter um form e uma div que daremos o nome de “resultado” para exibição dos resultados da consulta. O form deve ter um controle input, onde o evento onhotkey deve chamar uma função que fará a consulta.


Código HTML da página “index.html” do exemplo


<!DOCTYPE html PUBLIC "-//W3C//DTD XHTML 1.0 Transitional//EN" "http://www.w3.org/TR/xhtml1/DTD/xhtml1-transitional.dtd">


<html xmlns="http://www.w3.org/1999/xhtml">


<head>


<meta http-equiv="Content-Type" content="text/html; charset=iso-8859-1" />


<title>Exemplo de Live Search</title>


<style type="text/css">


<!--


body {


font-family: Arial, Helvetica, sans-serif; font-size: 0.7em;


color:#000;


margin:0;


padding:0;


}


#page {

width:720px;


height:100%;


margin-left:auto;


margin-right:auto;


margin-top:0;


padding:0;


}


#content {

width:85%;


margin-left:auto;


margin-right:auto;


padding:0;


padding-top:30px;


padding-left:5px;


padding-right:5px;


text-align:justify;
}


#resultado

{


background: #F5F5F5;


padding:15px;


border:#999 3px dashed;


}


.titulo {


font-size: 1.5em;


font-weight: bold;


text-align:center;


}


.subtitulo {

font-size: 1.3em;


font-weight: bold;


text-align:center;


}


label, input {
display: block;
}
fieldset {
border: dashed 3px #999;


background:#F5F5F5;


padding:15px;


}


-->

</style>


<script src="ajax.js" language="javascript" type="text/javascript"></script>


</head>


<body>

<div id="page">


<div id="content">


<span class="titulo">


Exemplo de Live Search usando AJAX, MYSQL E PHP


<br /><br />
</span>


<!-- este é o form de pesquisa, repare que não tem action e nem um controle submit-->


<form name="busca">
<fieldset>


<legend>Buscar frases</legend>


<!-- esta eh a caisa de pesquisa, repare no onkeyup chamando a funcao Buscar que fara a pesquisa-->


<input type="text" size="89" maxlength="255" name="texto" onkeyup="Buscar();" />
</fieldset>


</form>
<br />
<br />
<!-- essa div conterá o resultado da busca-->


<div id="resultado"><span class='subtitulo'>Digite uma palavra com mais de 2 (duas) letras. Por exemplo, <i>vida</i></span></div>


</div>


</body>


</html>


Este código HTML pode ser baixando na íntegra clicando aqui.


Salve o arquivo como “index.html” no seu servidor WEB.


Passo III – Criando o javascript da página “index.html”


O javascript da página, conterá funções que interpretam e tratam a entrada do usuário, que criam o xml request e lê o xml com o resultado da busca gerado dinamicamente e, por fim, formataram o resultado para o html adicionando a página.


Por razões óbvias, chamaremos esse arquivo de javascript de “ajax.js”, segue o código fonte do mesmo:


// JavaScript Document

var http_request = false;


//funcao que realiza a busca

function Buscar()


{


//pegando o valor do controle no form na pagina


var text = document.busca.texto.value;
//se o comprimento do texto for maior que dois


if (text.length >2)


{


//definindo pagina que fara a consulta e retornará o xml


var url = "buscar.php";


url += "?q="+text;


//gerando uma imagem do tipo carregando para que o usuario saiba que esta sendo feita uma busca no banco de dados


document.getElementById("resultado").innerHTML = "<div align='center' class='subtitulo'><img src='ajax-loader.gif' alt='Carregando...' /><br /><br />Carregando...</div>";


//chamando funcao que verifica se a busca pode ser feita


AtualizaResultado(url);


}


else


{


document.getElementById("resultado").innerHTML = "<span class='subtitulo'>Digite uma palavra com mais de 2 (duas) letras. Por exemplo, <i>vida</i></span>";


}


}


//coracao do ajax, cria o objeto xmlhttprequest e tenta lelo


function AtualizaResultado(url)


{


http_request = false;

if (window.XMLHttpRequest) { // Mozilla, Safari,...


http_request = new XMLHttpRequest();


if (http_request.overrideMimeType) {


http_request.overrideMimeType('text/xml');


}


} else if (window.ActiveXObject) { // IE


try {


http_request = new ActiveXObject("Msxml2.XMLHTTP");


} catch (e) {


try {


http_request = new ActiveXObject("Microsoft.XMLHTTP");


} catch (e) {}


}


}


if (!http_request) {

alert('Não foi possível criar uma instância XMLHTTP');


return false;


}


http_request.onreadystatechange = mudancaDeEstado; // essa funcao eh chamada quando o xml eh carregado


http_request.open('GET', url, true);


http_request.send(null);


}


//funcao que controi o resultado da busca

function mudancaDeEstado()


{


var retorno = "";


//definindo o xml


var xmldoc = http_request.responseXML;


//navegando para a tag item


var lst = xmldoc.getElementsByTagName('item');


var total = 0;


//criando a tabela para exibicao dos dados


retorno = "<table width='100%' border='0' cellpadding='2' cellspacing='2'>";


//percorrendo todos os itens


for (var i=0;i<lst.length;i++)


{


var frase = "";


var autor = "";


total = total +1;


var objNode = lst[i];


if (objNode.nodeType == 1)


{


for (var j=0;j<objNode.childNodes.length;j++)


{


var objNI = objNode.childNodes[j];


if (objNI.nodeType == 1)


{


switch (objNI.nodeName)


{


case "frase":


frase = objNI.firstChild.nodeValue;


break;


case "autor":


autor = objNI.firstChild.nodeValue;


break;


}


}


}


}


//criando row na tabela que conterá a frase e o autor


retorno += "<tr><td><i>&quot;"+frase+"&quot;</i> <strong>"+autor+"</strong></td></tr>";


}
if (total > 0)


{


retorno += "<tr><td><strong>"+total+" frase(s) listada(s)</strong></td></tr></table>";
}


else // no caso de não ter encontrado nenuma frase


{


retorno = "<span class='subtitulo'>Nenhuma frase encontrada com esta palavra</span>"


}


//escrevendo o resultado no documento


document.getElementById("resultado").innerHTML = retorno;


}


Para baixar o arquivo já pronto, clique aqui.


Você deve salvar este arquivo como “ajax.js” no mesmo diretório onde salvou o “index.html”, no seu servidor WEB.


Passo IV – Criando a página PHP que realizará a consulta no BD


Agora iremos confeccionar a página PHP que fará a consulta no banco de dados e formatará o resultado em um arquivo xml para ser usado pelo javascript. O nome do arquivo do exemplo será “search.php”.


Código fonte, lembre-se de alterar os dados da conexão ao banco de dados:


<?php

//capturando variaveis


$buscar = $_GET["q"];


//abrindo conexao com o bancode dados


$link = mysql_connect("hostmysqlqualquer", "usuario", "senha");


if (!$link)


{
echo 'Não foi possível selecionar o banco de dados';


die('Não foi possível conectar: ' . mysql_error());


}


if (!mysql_select_db('exemplo', $link))


{


echo 'Não foi possível selecionar o banco de dados';


exit;


}


//criando a consulta


$sql = "SELECT * FROM Frases";


if (isset($buscar) && $buscar != '')


{


$sql .= " WHERE frase LIKE '%".$buscar."%'";


$sql .= " ORDER BY frase";


}


//executando a consulta
$result = mysql_query($sql, $link);
if (!$result)


{


echo "Erro do banco de dados, não foi possível consultar o banco de dados\n";


echo 'Erro MySQL: ' . mysql_error();


exit;


}


//montando o xml de saida


echo '<?xml version="1.0" encoding="iso-8859-1"?>'."\n";


echo "<frases>\n";
while ($row = mysql_fetch_assoc($result))


{


echo "\t<item>\n";


echo "\t\t".'<frase>'.$row['frase'].'</frase>'."\n";


echo "\t\t".'<autor>'.$row['autor'].'</autor>'."\n";


echo "\t</item>\n";


}

mysql_close($link);
echo '</frases>';


?>


Se preferir baixá-lo, clique aqui.


Salve no mesmo diretório onde estão os outros arquivos, com o nome de “search.php”, no seu servidor WEB, coloque também a figura que será exibida quando a consulta estiver sendo executada no mesmo diretório, para baixá-la clique aqui.


Pronto! Agora é só acessar “index.html” do seu browser e testar se o exemplo está funcionando bem no seu servidor WEB. Não se esqueça de inserir alguns registros no banco de dados para poder testar a pesquisa! Valeu e até a próxima pessoal!


Por Solleon Menezes

quinta-feira, setembro 25, 2008

Publicando RSS com PHP e MYSQL

Se você ainda não sabe o que é RSS, dê uma lida no post RSS e asp.net parte I , que você encontrará os conceitos introdutórios sobre o tema. 


1. Introdução


Para que qualquer site possa servir RSS, é necessário que ele forneça ao programa leitor, um arquivo XML, contendo os dados, pois RSS, como já sabemos, é nada mais que um arquivo XML que segue uma padronização da estrutura específica. Podemos fornecer esse XML de duas formas, ou através de um arquivo estático XML propriamente dito salvo em nosso servidor, ou por meio de uma página PHP que pode gerar esse XML dinamicamente para nós. No nosso caso vamos gerar por meio de uma página PHP.


Antes de partirmos para a feitura da página, precisamos antes guardar as informações que publicaremos no RSS em algum lugar. Na informática, lugar de armazenar informações é em banco de dados. No nosso caso usaremos o banco open-source MySQL, disponível para download em http://www.mysql.com.


2. Criando o banco de dados


A estrutura do arquivo RSS é bem definida. Temos as seguintes entidades Channel e Item, que possuem a seguinte estrutura e se relacionam da seguinte forma:


O script para criação dessa estrutura é este:


SET @OLD_UNIQUE_CHECKS=@@UNIQUE_CHECKS, UNIQUE_CHECKS=0;
SET @OLD_FOREIGN_KEY_CHECKS=@@FOREIGN_KEY_CHECKS, FOREIGN_KEY_CHECKS=0;
SET @OLD_SQL_MODE=@@SQL_MODE, SQL_MODE='TRADITIONAL';

CREATE SCHEMA IF NOT EXISTS `RSS` ;
USE `RSS`;

-- -----------------------------------------------------
-- Table `RSS`.`Channel`
-- -----------------------------------------------------
CREATE  TABLE IF NOT EXISTS `RSS`.`Channel` (
  `idChannel` INT NOT NULL AUTO_INCREMENT ,
  `title` VARCHAR(255) NULL DEFAULT NULL ,
  `link` VARCHAR(255) NULL DEFAULT NULL ,
  `description` TEXT NULL DEFAULT NULL ,
  PRIMARY KEY (`idChannel`) )
ENGINE = InnoDB;


-- -----------------------------------------------------
-- Table `RSS`.`Item`
-- -----------------------------------------------------
CREATE  TABLE IF NOT EXISTS `RSS`.`Item` (
  `idItem` INT NOT NULL AUTO_INCREMENT ,
  `title` VARCHAR(255) NULL DEFAULT NULL ,
  `link` VARCHAR(255) NULL DEFAULT NULL ,
  `description` TEXT NULL DEFAULT NULL ,
  `idChannel` INT NULL DEFAULT NULL ,
  PRIMARY KEY (`idItem`) ,
  CONSTRAINT `fk_Item_Channel`
    FOREIGN KEY (`idChannel` )
    REFERENCES `RSS`.`Channel` (`idChannel` )
    ON DELETE RESTRICT
    ON UPDATE CASCADE)
ENGINE = InnoDB;

CREATE INDEX fk_Item_Channel ON `RSS`.`Item` (`idChannel` ASC) ;


SET SQL_MODE=@OLD_SQL_MODE;
SET FOREIGN_KEY_CHECKS=@OLD_FOREIGN_KEY_CHECKS;
SET UNIQUE_CHECKS=@OLD_UNIQUE_CHECKS;

Você também pode baixá-lo na integra aqui.


Para excecutar o script de criação, podemos abrir o prompt de comando e simplesmente digitarmos:


shell> mysql < arquivo_texto


Também podemos abrir o client mysql e digirtarmos:


mysql> source filename


O client fará tudo de forma automatizada e teremos nosso banco de dados criado.


3. Criando a página PHP para geração do RSS


A página PHP gerará primeiro uma string contendo todo o XML, depois enviará para o leitor de RSS o resultado. Segue abaixo o código fonte da página PHP:
<?php
//criando cabeçalho do arquivo
$xml = '<?xml version="1.0" encoding="iso-8859-1"?>'."\n";
$xml .= '<rss version="2.0">'."\n";

//setando dados da conexao e do banco voce deve substituir pelos seus dados de conexão
$host = "mysql.test.com";
$user = "usuario";
$pass = "senha";
$db = "RSS";

//fazendo a conexão com o banco de dados que contem os dados RSS
mysql_connect($host, $user, $pass);
mysql_select_db($db);

//pegando dados do channel no banco
$sql = "SELECT idChannel, title, description, link FROM Channel ORDER BY idChannel DESC";
$reschan = mysql_query($sql);

//enquanto ainda houver dados do channelm executar codigo dentro do while
while ($rowchan = mysql_fetch_assoc($reschan))
{
    //abrindo tag do Channel
    // obs: \n = nova linha   
    $xml .= '<channel>'."\n";
   
    //formatando os dados nas tags rss do Channel   
    $xml .= '<title>'.htmlspecialchars($rowchan['title']).'</title>'."\n";
    $xml .= '<description>'.htmlspecialchars($rowchan['description']).'</description>'."\n";
    $xml .= '<link>'.htmlspecialchars($rowchan['link']).'</link>'."\n";
   
    //pegando dados dos Itens do Channel no banco de dados
    $sql = "SELECT title, link, description FROM Item WHERE idChannel = ".$rowchan['idChannel']." ORDER BY idItem DESC";
    $result = mysql_query($sql);
   
    //enquanto ainda houver itens no banco, executar codigo dentro do while
    while ($row = mysql_fetch_assoc($result))
    {
        //formatando dados do item nas tags RSS
        $xml .= '<item>'."\n";
        $xml .= '<title>'.htmlspecialchars($row['title']).'</title>'."\n";
        $xml .= '<description>'.htmlspecialchars($row['description']).'</description>'."\n";
        $xml .= '<link>'.htmlspecialchars($row['link']).'</link>'."\n";
        $xml .= '</item>'."\n";
    }
   
    //fechando tag do channel
    $xml .= '</channel>'."\n"; 
}

//fechando a tag rss
$xml .= '</rss>';

//retornando todo o xml pro leitor de rss do usuário
echo $xml;
?>
O código fonte acima pode ser baixado aqui. Salve a página PHP em seu servidor PHP e pronto! Bastará colocar o endereço da página no seu leitor de RSS e você verá que funciona!


4. Testando


Para testar o código da página PHP, fizemos um exemplo que você pode ver aqui. Se tudo der certo ao vizualizar no  Firefox você verá uma página semelhante a essa:


Por Solleon Menezes

quarta-feira, agosto 30, 2006

Introdução à POO tendo c# como guia - parte 1

O objetivo deste artigo é ser uma introdução à Programação Orientada a Objetos (POO) primeiro a partir de um escopo global, depois sob a ótica do C#.

Se você já é programador, mas não conhecia ou utilizava POO em suas soluções, provavelmente sentirá uma enorme dificuldade em se adequar à POO, pois adotar POO é enxergar a programação sob um aspecto completamente diferente do usual. Apesar de difícil no início, POO traz enormes vantagens em termos de reusabilidade de código (você digitará menos e de forma mais eficiente =] ), melhoria na lógica da aplicação (ficará mais fácil “ver” como seu sistema funciona), manutenção (alterações nos programas serão menos traumáticas), colaboração (ficará mais fácil dividir o trabalho em equipe), etc. Você talvez esteja se perguntando; “Se POO integra todos esses benefícios, por que não é unanimidade entre os desenvolvedores?” Como dito no início, aprender POO não é fácil, mas o pior mesmo é alterar velhos hábitos cultuados por 50 anos de desenvolvimento de software baseado em programação estruturada.

CLASSES E OBJETOS

As linguagens orientadas a objeto, tem como idéia primordial tornar a estrutura e a lógica do programa um pouco mais próximos do mundo “real”. Basicamente temos em uma mesma unidade lógica funcional, que armazena em sua estrutura dados (equivalentes às variáveis) e meios de manipulá-los (equivalentes a procedimentos e funções). Estes dados são chamados de “campos de dados” e os meios de manipulação “campos de funções”. Tal unidade lógica é chamada de CLASSE. Recomendo que fixe bem este parágrafo antes de passar aos demais.

Uma classe é considerada um tipo de dado, como os tipos básicos pré-definidos (inteiro, real, string, etc.) em todas as linguagens de programação. O que quero dizer é que da mesma forma que podemos criar uma variável do tipo “boolean” também podemos criar uma variável do tipo da classe. Esta variável da classe é chamada de OBJETO.

Ao definirmos uma classe, estamos fornecendo o esqueleto para o objeto. Toda vez que declaramos uma variável originada de uma classe dizemos que ‘instanciamos um objeto”. Os campos de dados de uma classe após serem instanciados são chamados de “variáveis de instância” e os campos de funções de “métodos” ou “funções membros”. Então POO é isso? Definir tipos novos e usá-los? Na verdade a coisa é bem mais profunda. Quando definimos uma classe estamos criando um modelo – um molde – para criarmos objetos e/ou outras classes. Para que a POO esteja bem implementada os campos de dados não devem ser vistos e alterados de fora da classe diretamente. Quem deve manipular estes dados e “enxergá-los” são os campos de funções. Assim qundo este princípio da POO é seguido em uma classe, dizemos que os campos de dados estão “escondidos” ou seja, NÃO DEVEM SER ACESSADOS DIRETAMENTE DE FORA DE UMA CLASSE! Ok, mas porque devemos ter todo esse cuidado com os estes dados? Tal precaução existe para evitarmos alterações acidentais em dados que possam comprometer o bom funcionamento do programa. Assim ao declararmos um campo dentro de uma classe estamos escondendo-o do resto da aplicação. Também existe para evitarmos conflitos de nomes de variáveis, pois ambas não se enxergam. Isolar campos de dados e fazê-los ser acessíveis somente por campos de funções é uma técnica conhecida como encapsulamento. Encapsular sigifica esconder toda a complexidade do tratamento dos campos de dados, rotinas, etc. de fora de uma classe. Podemos “encapsular” tanto campos de dados quanto campos de funções. Quando os campos de dados estão encapsulados e escondidos fica fácil saber quando, como e onde um campo é acessado e alterado pois somente determinados campos de funções (métodos) podem acessá-los. Dentro dessa perspectiva existem campos de funções especiais, conhecidos como PROPRIEDADES. As propriedades de fora de uma classe são vistas como campos “descobertos”, mas de dentro da classe, são funções membros que permitem um meio seguro de acessar os campos de dados. As propriedades podem acessar campos de dados diretamente ou mesmo retornar valores calculados como se fossem campos de dados. Quando uma propriedade somente tem valor de retorno a mesma é dita como somente leitura. Quando chamamos uma função membro de um objeto, dizemos que estamos trocando mensagens com o objeto. De fato um programa em POO consiste em diversos objetos trocando mensagens entre si.

HERANÇA

Além de tudo POO possibilita a herança. Herança é uma forma de relacionarmos classes passando seus campos para outras de maneira hierárquica. Dessa forma se temos uma classe chamada “seres” com a característica “existir” ao relacionarmos esta como ponto chave da hierarquia com as classes “seres vivos”, “seres inanimados”, ambas herdaram da classe “seres” a característica “existir”. A classe que cede as características as demais é conhecida como “classe base” ou pai, e as que herdam “derivadas” ou filhas. A implementação de classes devem obedecer as características comuns a todo o sistema e então ir afunilando em características individuas de cada unidade do mesmo. Esta forma de progamação simplifica enormemente a manutenção do sistema, pois ao alterarmas uma característica em uma classe pai, automaticamente todas as filhas herdaram esta mudança. Ganhamos então um código altamente estruturado. Esta característica da POO é sem sombra de dúvidas um aliado fortíssimo das aplicações robustas e bem gerenciadas.

POFIMORFISMO E SOBRECARGA

Outra característica muito interessante e essencial se chama pofimorfismo, que é a capacidade campos de funções compartilhar o mesmo nome mas terem parâmetros, rotinas e saídas diferentes. Um caso particular de polimorfismo é chamado de sobrecarga. Sobrecarga ocorre por exemplo com o operado +, que serve para somas entre inteiros, reais, concatenação de strings, etc. O modo como o sistema processa cada uma das operações é completamente diferente.